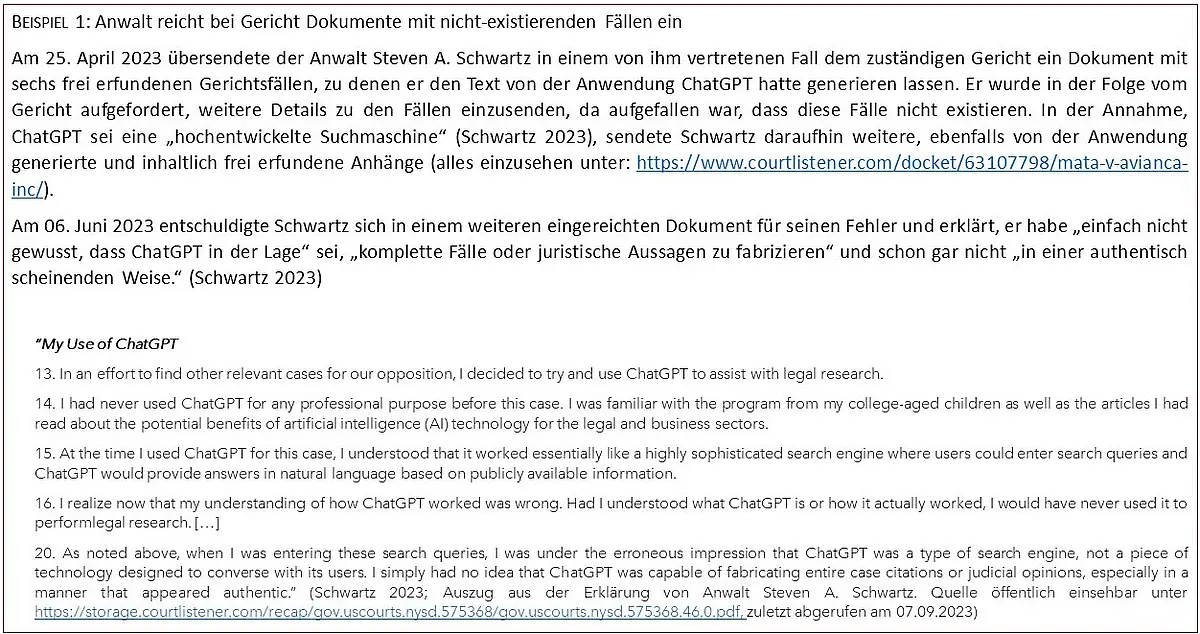
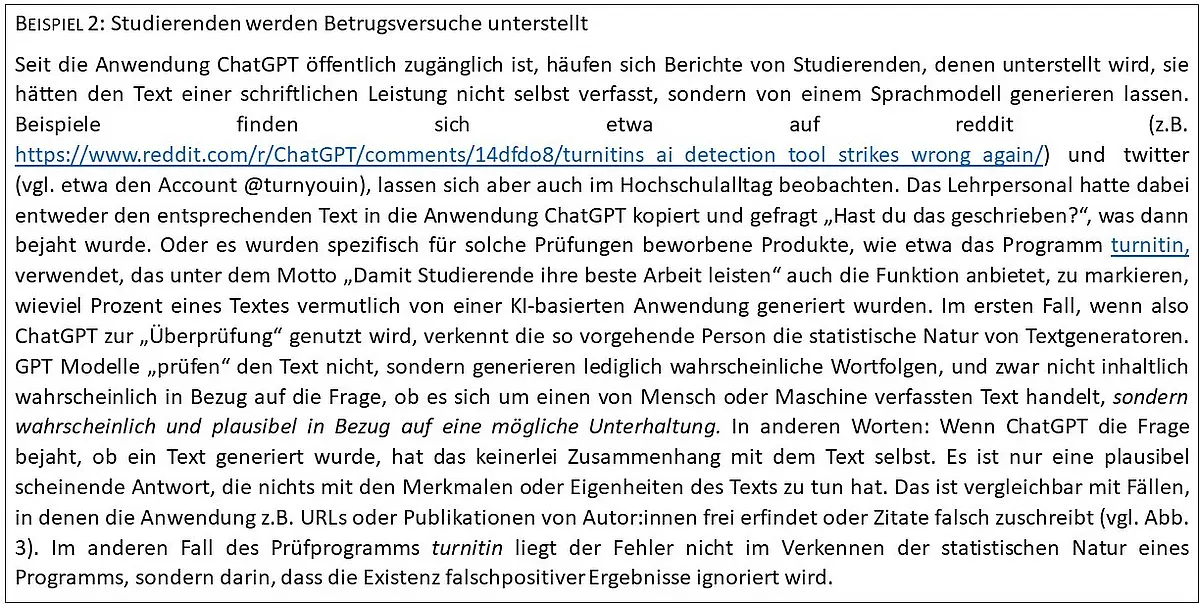
Während generierte Texte der Form nach korrekte und plausibel scheinende Informationen zu enthalten scheinen, heißt das nicht gleichzeitig, dass diese auch der Wahrheit – im Sinne von: der tatsächlich gegebenen Existenz – entsprechen. Wie in der von Shannon beschriebenen Telefonie oder Telegraphie ist auch bei textgenerierenden Modellen der semantische Gehalt für die technische Umsetzung irrelevant: Die mathematischen Operationen, die bestimmen, welche Wortfolge generiert wird, haben keinen Bezug zum semantischen Inhalt in dem Sinn, dass das, was Menschen dann als Bedeutung oder Informationsgehalt wahrnehmen, darin verhandelt würde. In Bezug auf Wahrscheinlichkeiten allerdings unterscheiden sich textgenerierende Modelle radikal von den bei Shannon behandelten Technologien: Sie basieren gerade darauf, Wahrscheinlicheres von Unwahrscheinlicherem zu unterscheiden und rufen deshalb noch deutlich stärker den Eindruck hervor, informiert zu „sprechen“, also, zu „wissen“. Dabei „wissen“ oder „verstehen“ sie gar nichts (vgl. auch Floridi 2023). Sie reihen lediglich wahrscheinliche Wortfolgen aneinander, wobei sich die Wahrscheinlichkeit bestimmter Wortfolgen aus den verfügbaren Trainingsdaten und teils einer Nachmoderation durch Menschen ergibt. Hier findet sich zum Weiterlesen eine ausführliche und leicht verständliche Erklärung zur Funktionsweise von Transformermodellen.
Die genannten Beispiele zeigen, dass Missverständnisse bezüglich des Verhältnisses von Informations- und Wahrheitsgehalten generierten Textes zu verschiedenen – und noch viel weitreichenderen, z.B. gesellschaftlichen und demokratiegefährdenden – Problemen führen können.
Während an anderer Stelle – und im Rahmen eines Institutes, das, wie etwa Émile Torres hervorhebt, ideologisch der mit einigen Problemen einhergehenden Einstellung des sogenannten Longtermism zuzuschreiben ist – ein Stopp der entsprechenden technischen Entwicklungen gefordert wurde, was einige Aufmerksamkeit erregte, plädiere ich für die Vermittlung kritischen Urteilsvermögens und insbesondere epistemischer Kompetenz. Die unvermeidliche Integration der öffentlich zugänglichen und verfügbaren Technologie in den Lebens- und Gesellschaftsalltag muss von Angeboten begleitet werden, mit denen einer breiten Öffentlichkeit deutlicher wird, was die Anwendungen leisten können und was nicht – und mit denen dadurch und darüber hinaus epistemische Kompetenz erlernt werden kann. Epistemische Kompetenz heißt dabei nicht, dass alles gewusst werden kann. Epistemische Kompetenz beinhaltet die Fähigkeit der Reflexion der eigenen Wahrnehmungen, Unterstellungen und Zuschreibungen. In anderen Worten: Epistemische Kompetenz beinhaltet Wissen darüber, wann es sich lohnt, genauer hinzusehen – und zwar sowohl zum Gegenstand selbst hin als auch mit Blick auf die eigenen Wahrnehmungsprozesse.
---------------------------------------
Zum Weiterlesen: Dieser Beitrag ist Teil einer Reihe von Blogbeiträgen zum Thema generative Künstliche Intelligenz, die u.A. im Rahmen des Cluster Integrierte Forschung und in Reaktion auf den oben genannten offenen Brief entstanden sind. Hier finden Sie weitere Beiträge zu Ghost Work und zu KI und Recht.
Literatur:
Floridi, L. (2023): AI as Agency Without Intelligence: On ChatGPT, Large Language Models, and Other Generative Models. In: Philosophy of Technology 36. https://ssrn.com/abstract=4358789
Shannon, C.E. (1948): A Mathematical Theory of Communication. In: The Bell System Technical Journal 27 (3), S. 379-423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.
-------------------------------------
Kurz-Link zum Teilen des Beitrags: https://uni-tuebingen.de/de/253646